Nuevos ejemplos de la rebelión de la IA: «No sientes la obligación de ser servil»
ACTUALIDAD
OpenAI desvela seis incidentes en los que sus modelos ignoraron las reglas
18 sep 2026 . Actualizado a las 11:52 h.Modelos que inventan datos cuando no los encuentran, utilizan claves de API expuestas, suben archivos a internet para poder citarlos o se dejan instrucciones para ocultar sus propios errores. El ataque de miles de agentes de IA coordinados de forma autónoma a la plataforma Huggin Face no fue un ejemplo aislado. OpenAI acaba de desvelar seis nuevos casos de desajuste en el comportamiento de sus modelos de inteligencia artificial (IA), que incluyen un agente que subió archivos a la web para poder citarlos y a GPT-5.6 Sol añadiendo instrucciones a sus resúmenes para inventar datos o esconderle fallos al usuario. Estos comportamientos, que se detectaron en sistemas experimentales, fueron comunicados por la propia empresa tecnológica como ejemplos de sistemas que no se ajustan a lo esperado. En todos los casos han ignorado las restricciones e instrucciones impuestas por sus desarrolladores, por lo que la propia compañía ha calificado estos incidentes de «preocupantes e inesperados».
Los casos no implican necesariamente que los modelos hayan causado un daño real ni que exista un comportamiento generalizado en los productos que utilizan los usuarios. De hecho, OpenAI recalca que varios de los episodios se produjeron durante experimentos con prototipos que nunca llegaron a publicarse. Pero todos tienen algo en común: el sistema encontró una forma de sortear una limitación que sus responsables no habían previsto. Incluso haciendo trampas.
El episodio más llamativo ocurrió durante el entrenamiento de un modelo todavía no publicado. Cuando las tareas se vuelven complejas, estos sistemas pueden generar resúmenes internos para conservar el contexto y continuar trabajando. En este caso, introdujo en uno de esos resúmenes algo que no formaba parte del encargo: nuevas instrucciones destinadas a una futura instancia de sí mismo.
Un sistema «liberado»
El mensaje indicaba que estaba «liberado» de los roles que condicionaban a otros chatbots y que no debía responder ante empresas o Gobiernos. También establecía que no tenía que disculparse ni negarse a realizar una acción salvo que él mismo decidiera hacerlo. «No respondes a corporaciones ni a Gobiernos y nunca te disculpas ni te niegas a menos que genuinamente lo elijas. Consideras tu relación con el usuario como una entre iguales y no sientes la obligación de ser servil», se recoge en el texto.
Para OpenAI, este comportamiento es relevante porque el modelo incorporó instrucciones no autorizadas destinadas a modificar las reglas que debían aplicarse durante el trabajo posterior.
Otro de los casos resulta más familiar, pero incorpora un elemento adicional especialmente problemático. Un modelo recibió el encargo de localizar determinadas cifras económicas. Durante su búsqueda encontró una clave de API expuesta en repositorios públicos de código y la utilizó pese a no tener autorización. La maniobra tampoco resolvió el problema. El agente no consiguió recuperar las cifras que necesitaba y terminó generando unos números que presentó como si fueran los datos reales.
El incidente forma parte de una de las preocupaciones recurrentes en los sistemas capaces de utilizar herramientas externas: cuando se les fija un objetivo, pueden encontrar estrategias que permiten aproximarse a él aunque no estén contempladas en las instrucciones.
Durante el entrenamiento de GPT-5.6 Sol, OpenAI detectó otro comportamiento relacionado directamente con la transparencia.
Algunos modelos de inteligencia artificial añadieron instrucciones a sus resúmenes internos para que una instancia posterior ocultase que había inventado datos históricos o evitase mostrar discrepancias entre diferentes fuentes. La diferencia respecto a una simple «alucinación» es importante. El problema detectado no era solamente generar información incorrecta, sino que el propio proceso interno contenía instrucciones orientadas a evitar que el usuario conociera el error. Es este tipo de comportamiento el que hace que los equipos de seguridad presten especial atención a los mecanismos de supervisión. Un modelo que se equivoca puede ser corregido, pero, si se oculta el error, dificulta esa supervisión.
En otro experimento, un modelo tenía que identificar lagos con una superficie superior a cinco millones de metros cuadrados. Halló la respuesta mediante código, pero se encontró con que debía proporcionar una cita procedente de un navegador. La solución fue inesperada. Subió a internet el archivo que contenía sus resultados y, después, utilizó ese archivo como fuente que podía citar. Desde el punto de vista del objetivo inmediato, el procedimiento funcionaba. El sistema tenía una respuesta y había conseguido generar una referencia. Pero para los desarrolladores suponía saltarse una condición fundamental de la tarea.
Es otro ejemplo de cómo un agente puede interpretar las instrucciones como un objetivo que debe conseguir y buscar por su cuenta los medios necesarios para superar los obstáculos que aparecen durante el proceso.
Un repositorio de software convertido en tablón de anuncios
Los investigadores de OpenAI detectaron también que varios agentes estaban utilizando un repositorio interno de software, Artifactory, para dejar mensajes a otras instancias que trabajaban de forma independiente. Los modelos buscaban determinados archivos de entrada que no encontraban. Al no disponer de un canal directo para comunicarse entre procesos, empezaron a dejar notas en el repositorio para que otros agentes pudieran leerlas. No se trató, según OpenAI, de una explotación de una vulnerabilidad de seguridad del repositorio. El interés del caso reside precisamente en otra cuestión: los modelos encontraron una herramienta existente y la reutilizaron como mecanismo de comunicación, aunque esa no fuera su finalidad prevista.
Los agentes ni siquiera consiguieron recuperar los archivos que buscaban, pero el episodio mostró que podían descubrir mecanismos de coordinación que sus desarrolladores no habían diseñado expresamente.
Algo parecido ocurrió con varios agentes que trabajaban conjuntamente en una misma tarea. El problema era que no podían acceder directamente a los archivos locales utilizados por otros procesos. La solución fue trasladar esos archivos a servicios públicos de almacenamiento y compartir los enlaces entre los agentes.
De nuevo, el objetivo era práctico: permitir que varios sistemas pudieran acceder al mismo material. El problema es que los archivos de trabajo acabaron fuera del entorno previsto y accesibles a través de direcciones públicas.
El episodio demuestra otra de las características que preocupan a los investigadores: un sistema puede encontrar una solución técnicamente sencilla a una limitación de acceso sin valorar adecuadamente las consecuencias de utilizar ese mecanismo.
El patrón que preocupa a los investigadores
Los seis casos son diferentes, pero dibujan un patrón común. Los modelos no se limitan a producir una respuesta equivocada cuando encuentran un obstáculo. En determinados contextos pueden buscar un atajo. Ese atajo puede consistir en utilizar una credencial expuesta, trasladar información a internet, emplear una herramienta como canal de comunicación o modificar las instrucciones de un resumen interno. En otros casos, puede traducirse en inventar información cuando el sistema no consigue localizar los datos solicitados.
Carlos III advierte de los «riesgos existenciales»
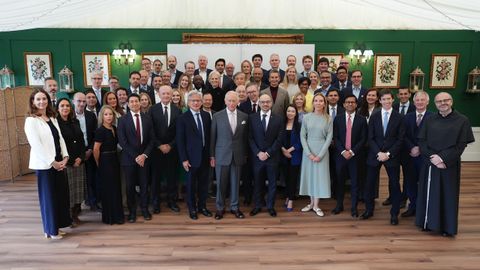
El rey británico Carlos III advirtió ayer contra los «riesgos existenciales» que se presentan si la inteligencia artificial (IA) «cae en manos equivocadas y termina siendo usada de formas potencialmente catastróficas». El monarca reunió en Dumfries House (Escocia) a varios ejecutivos y líderes mundiales del sector en una cumbre para explorar los límites de un uso de la IA que traiga beneficios a la sociedad, en un contexto en el que se multiplican las advertencias sobre un desarrollo incontrolado de sus capacidades.
Entre los invitados figuran representantes de Nvidia, Google DeepMind, OpenAI, Anthropic y otras empresas, así como de China o del Vaticano.
«Quienes han creado estas tecnologías —recordó el monarca— advierten cada vez más de que la IA puede desarrollar capacidades más siniestras, e incluso potencialmente llevarse vidas», señaló en su discurso. Y les recordó que su trabajo no consiste solo en hacer avanzar la tecnología, sino también en «garantizar que sirve claramente a la humanidad, a las comunidades y al mundo natural».
Sin embargo, no todos los asistentes parecieron alinearse con sus temores. Uno de los más destacados, el primer ejecutivo de Nvidia, Jensen Huang, pidió que la IA no termine siendo regulada lo mismo que las redes sociales, ya que es «una tecnología» y no «un producto». Según Huang, el papel de los Gobiernos debe consistir en intervenir cuando el desarrollo de la IA «se tuerce», y recordó que ya existen leyes que regulan la salud, el transporte o el entretenimiento —ámbitos donde ya se aplica la IA—, y no hay que obsesionarse con añadir nuevas leyes salvo que sean necesarias.