Cómo funciona el software de lectura de códigos de barras para documentos de identidad
Los códigos de barras almacenan información clave de los documentos de identidad, pero leer sus datos es solo el primer paso para comprobar su autenticidad
En la verificación de identidad, incorporar nuevas tecnologías no significa necesariamente dejar atrás las anteriores. Muchos elementos de lectura mecánica siguen utilizándose porque son prácticos, económicos y compatibles con una amplia variedad de sistemas.
Los códigos de barras son un buen ejemplo. Permiten almacenar información en un formato visual que puede ser interpretado automáticamente por una máquina. Aunque son más sencillos que otros elementos presentes en los documentos de identidad, pueden desempeñar un papel importante tanto en el procesamiento de datos como en la verificación documental.
Además, no requieren necesariamente equipos especializados: muchos códigos de barras pueden capturarse con la cámara de un smartphone.
En este artículo veremos qué tipos de códigos de barras aparecen en los documentos de identidad, qué información pueden contener y cómo un software especializado puede leer, interpretar y utilizar esos datos durante la verificación.
En resumen:
- Los códigos de barras pueden contener nombres, fechas, números de documento, direcciones, fotografías, datos biométricos, certificados, URL, códigos de acceso y firmas digitales.
- Entre los formatos más habituales en documentos de identidad se encuentran PDF417, QR, Code 128, Code 39, Data Matrix, ITF-14 y Aztec Code.
- Leer un código de barras no equivale a verificarlo. Para evaluar un documento, sus datos deben validarse y, cuando corresponda, compararse con otras fuentes, como la zona de inspección visual (VIZ), la zona de lectura mecánica (MRZ) o el chip RFID.
¿Qué tipos de códigos de barras se utilizan en los documentos de identidad?
Los códigos de barras se dividen principalmente en dos categorías: 1D y 2D.
Los códigos 1D o lineales almacenan la información horizontalmente mediante líneas paralelas de diferentes grosores y espacios. Los códigos 2D, en cambio, utilizan tanto la dimensión horizontal como la vertical, por lo que pueden almacenar una mayor cantidad de información en un espacio reducido.
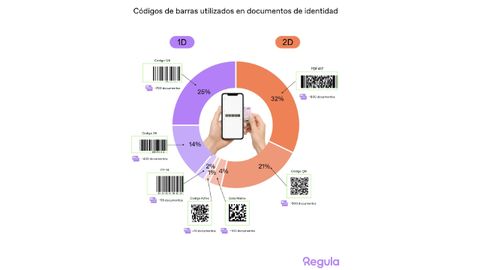
Aunque existen numerosos formatos, en los documentos de identidad predominan siete tipos: tres 1D y cuatro 2D.
Códigos de barras 1D
Code 128
Code 128 se caracteriza por su alta densidad de información y su versatilidad. Puede codificar todos los caracteres ASCII, por lo que resulta adecuado para almacenar identificadores y otros datos personales.
Es uno de los códigos lineales más habituales en documentos de identidad y aparece principalmente en tarjetas de identidad y licencias de conducir.
Code 39
Desarrollado en la década de 1970, Code 39 permite representar letras, números y algunos caracteres especiales. Su estructura relativamente sencilla facilita la lectura y decodificación mediante diferentes sistemas.
En los documentos de identidad suele utilizarse para almacenar números de documento, fechas u otros identificadores breves.
ITF-14
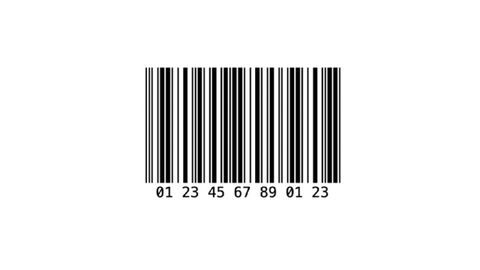
ITF-14 está diseñado principalmente para representar números y puede incluir un dígito de control para comprobar la integridad de la información.
Su alta densidad permite almacenar datos en un espacio relativamente pequeño. Sin embargo, es menos frecuente en documentos de identidad que Code 128 o Code 39.
Códigos de barras 2D
Los códigos 2D ofrecen una capacidad mucho mayor. Dependiendo del documento y de la autoridad emisora, pueden incluir información personal, datos del documento, fotografías, información biométrica, certificados, firmas digitales, URL o códigos de acceso.
PDF417
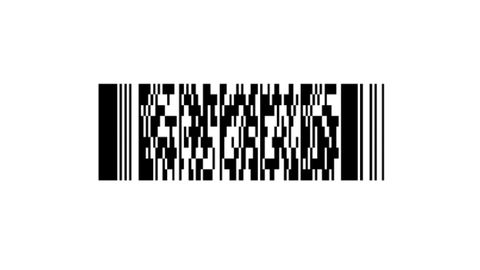
PDF417 es uno de los formatos más utilizados en documentos de identidad. Su principal ventaja es la capacidad de almacenar una cantidad considerable de información, incluso fotografías o datos relacionados con huellas dactilares.
Puede encontrarse en pasaportes, tarjetas de identidad y, especialmente, licencias de conducir.
Sin embargo, su elevada densidad también plantea desafíos. La curvatura del documento, una captura inclinada o la distorsión de perspectiva pueden dificultar la identificación correcta de sus filas y columnas.
Además, su formato rectangular puede resultar menos conveniente para la captura con smartphones que los códigos cuadrados.
Código QR
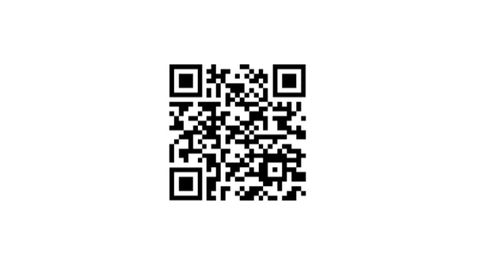
Los códigos QR nacieron para aplicaciones industriales, pero actualmente se utilizan en sectores muy diversos, desde pagos hasta autenticación de productos y documentos de identidad.
Pueden almacenar texto, URL y grandes cantidades de información estructurada. En documentos de identidad, esto puede incluir nombres, fechas, fotografías e incluso información relacionada con biometría.
Su formato cuadrado también facilita la captura con dispositivos móviles.
Data Matrix
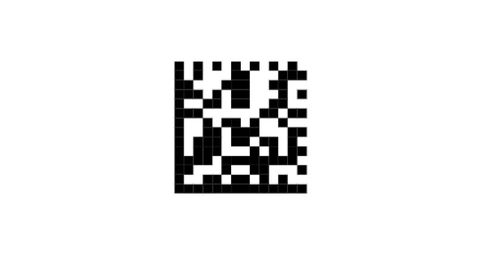
Data Matrix destaca por su capacidad para almacenar mucha información en un espacio muy reducido.
También ofrece una alta tolerancia a daños: gracias a sus mecanismos de corrección de errores, un código puede seguir siendo legible aunque algunas de sus celdas estén deterioradas.
En documentos de identidad es menos habitual que PDF417 o QR, pero puede encontrarse, por ejemplo, en determinados documentos europeos.
Aztec Code
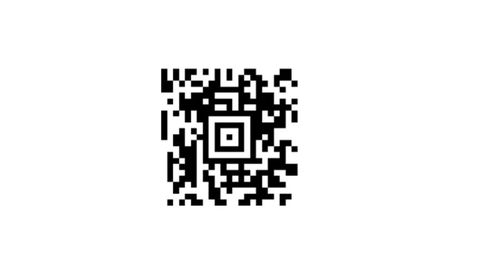
Aztec Code tiene una apariencia similar a un código QR, aunque su información se organiza alrededor de un núcleo central.
Es compacto, resistente a errores y puede almacenar una cantidad considerable de datos. Aun así, su presencia en documentos de identidad sigue siendo relativamente limitada.
VDS y credenciales digitales: una nueva función para los códigos de barras
Los formatos de códigos de barras utilizados en documentos de identidad llevan décadas existiendo. Lo que está evolucionando es la forma de estructurar, proteger y verificar la información que contienen.
Un ejemplo importante es el sello digital visible (VDS). Se trata de un código QR o Data Matrix que almacena información sobre un documento junto con una firma digital destinada a proteger los datos frente a modificaciones.
Los VDS ya se utilizan en determinados documentos, incluidas visas, y pueden contener datos como el nombre del titular, fechas, número de visa, número de pasaporte y otros detalles.
Los códigos de barras también tienen un papel relevante en el desarrollo de las credenciales digitales de viaje y otros documentos digitales. En estos escenarios, los datos pueden estar firmados digitalmente para facilitar la comprobación de su autenticidad.
Por su bajo costo, facilidad de implementación y compatibilidad con dispositivos comunes, los códigos de barras probablemente seguirán formando parte del ecosistema de identidad durante mucho tiempo.
¿Cómo funciona el software de lectura de códigos de barras?
En la verificación de documentos, el procesamiento de un código de barras puede dividirse en tres etapas principales: detección, lectura y decodificación, y análisis de datos.
1. Detección
Cuando el sistema recibe un documento que todavía no ha identificado, primero busca elementos que puedan corresponder a códigos de barras. A continuación, analiza cada candidato y determina de qué tipo se trata.
Si el software ya ha reconocido la plantilla del documento, este paso puede simplificarse. El sistema conoce de antemano dónde debería encontrarse el código de barras y qué formato debería tener.
2. Lectura y decodificación
Una vez localizada el área correspondiente, el software lee el código y convierte la información visual en datos digitales.
Los códigos 2D suelen incorporar mecanismos de corrección de errores. Estos permiten recuperar información incluso cuando parte del código está deteriorada o la imagen presenta defectos.
Cuanto mayor sea el nivel de corrección, mayor será la capacidad de recuperación. Sin embargo, esa protección adicional también ocupa espacio que podría utilizarse para almacenar otros datos.
3. Análisis de los datos
Decodificar un código de barras produce datos sin procesar. Para utilizarlos en un flujo de verificación, es necesario interpretarlos y convertirlos en campos estructurados.
Estos campos pueden incluir nombres, fechas, números de documento, imágenes, información biométrica, firmas electrónicas, certificados, URL o códigos de acceso, como el número de acceso a la tarjeta (CAN).
Regula Document Reader utiliza más de 200 analizadores para procesar datos codificados de acuerdo con estándares como ICAO, AAMVA e ISO, además de formatos específicos de determinados documentos.
La cantidad de información que puede extraerse depende, en última instancia, de cómo la autoridad emisora haya estructurado y protegido los datos.
Leer no es lo mismo que verificar
Que un sistema pueda leer correctamente un código de barras no significa que el documento sea auténtico.
Desde el punto de vista de la verificación, existen dos grandes escenarios: códigos cuyos datos están protegidos mediante una firma digital y códigos sin protección criptográfica adicional.
Cuando existe una firma digital y se dispone de los certificados correspondientes del emisor, el sistema puede comprobar la autenticidad e integridad de los datos.
Cuando no existe esa protección, es necesario recurrir a otros indicadores. Por ejemplo:
- el tipo de código de barras esperado;
- su tamaño y posición;
- el número de filas y columnas;
- el nivel de corrección de errores;
- la estructura y el formato de los datos.
El software también puede comparar la información del código de barras con otros elementos del documento. Una discrepancia entre el código, la VIZ, la MRZ o los datos del chip puede indicar que se requiere una comprobación adicional.
Por eso, para verificar documentos de identidad no basta con utilizar un lector genérico de códigos de barras. El sistema también debe comprender las características del documento que está procesando.
¿Qué afecta la precisión de la lectura?
Calidad y contraste de la imagen
Para interpretar un código de barras, el software debe distinguir con precisión sus diferentes elementos.
Una imagen desenfocada, con poca iluminación, reflejos o baja resolución puede reducir el contraste y dificultar la lectura. Esto resulta especialmente relevante durante el onboarding remoto, donde los usuarios utilizan diferentes smartphones y capturan los documentos en condiciones muy variadas.
El desgaste físico también influye. En documentos antiguos, los códigos pueden estar descoloridos, rayados o parcialmente dañados.
Tamaño y densidad
No basta con considerar el tamaño físico del código. También importa cuánta información contiene.
Un código relativamente grande puede seguir siendo difícil de leer si sus elementos individuales son muy pequeños. En estos casos, la resolución de la cámara y la distancia de captura son determinantes.
Variaciones entre documentos
Incluso un mismo formato de código de barras puede presentar diferencias importantes.
Los códigos pueden estar comprimidos, estirados, girados o adaptados al diseño de un documento específico. También pueden variar la posición, las proporciones y la estructura de los datos según el emisor.
Por este motivo, el conocimiento de las plantillas reales de documentos resulta especialmente valioso para la verificación de identidad.
¿Qué debe ofrecer un lector de códigos de barras para documentos de identidad?
Una solución especializada debería poder procesar distintos formatos 1D y 2D, trabajar con imágenes de calidad variable y gestionar códigos inclinados, girados, deformados o parcialmente dañados.
También debería ser capaz de interpretar los formatos de datos utilizados por diferentes autoridades emisoras y, sobre todo, integrar la lectura del código de barras en un proceso completo de verificación documental.
Regula Document Reader SDK combina estas capacidades con el conocimiento de las plantillas de documentos:
- procesa códigos de barras a partir de fotografías, escaneos y video;
- admite diferentes condiciones y escenarios de captura;
- utiliza información específica sobre documentos para comprobar las características del código;
- cuenta con analizadores para convertir los datos codificados en información estructurada;
- funciona en diferentes plataformas y dispositivos;
- permite comparar la información del código de barras con otros datos del documento.
De esta forma, el código de barras deja de ser simplemente una fuente de datos y se convierte en otro elemento que contribuye a evaluar el documento en su conjunto.
¿Quiere comprobar cómo funciona en la práctica? Hable con los expertos de Regula o pruebe Regula Document Reader.